
こんにちは HEROです。
今回は前Amazon Rekognitionで試した画像と全く同じものを、Microsoftが提供する画像分析「Computer Vision API」を使って検証を実施してみます。
Computer Vision API 画像の分析
Computer Vision APIは こちら のURLから画像を指定するだけで気軽に試すことができます。
タグ付け、説明はもちろんAmazon Rekognitionと同様に成人向けかどうかといった項目が検出できます。
実査に取得できる項目は下記です。
■項目名
説明(画像の説明)
タグ
画像形式(Jpegなど)
画像サイズ
クリップ アートの種類
線画の種類
モノクロ
成人向けコンテンツ
成人スコア
わいせつ性
わいせつスコア
カテゴリ
顔
背景のドミナント カラー
前景のドミナント カラー
アクセント カラー
日本語で表記される分直接的ですね。
早速前回の画像を試してみます。
試してみた
今回はAmazon Rekognitionと同様の「風景」「人物」「ネタ画像」といった題材で試しました。
■風景
風景で使った画像はコチラです。
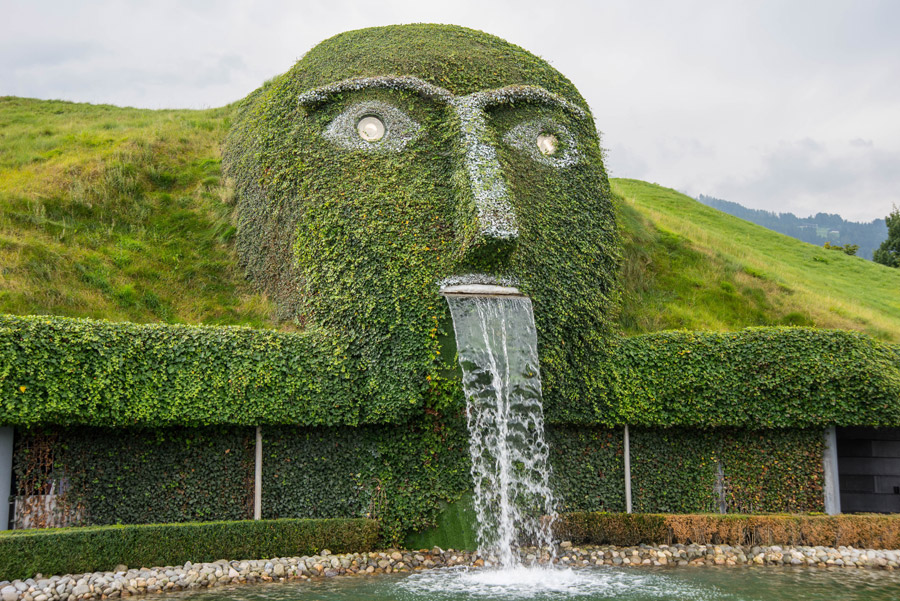
説明 { “tags”: [ “outdoor”, “grass”, “green”, “building”, “front”, “water”, “sitting”, “bench”, “man”, “garden”, “large”, “old”, “standing”, “field”, “yellow”, “white”, “brick”, “hydrant”, “riding”, “sheep”, “phone” ], “captions”: [ { “text”: “a large brick building with green grass”, “confidence”: 0.4514739 } ] }
「hydrant”(消化器)」は水を参照してるのでしょうか。電話もきになるところ。
■人物
次は人物の画像で試してみます。
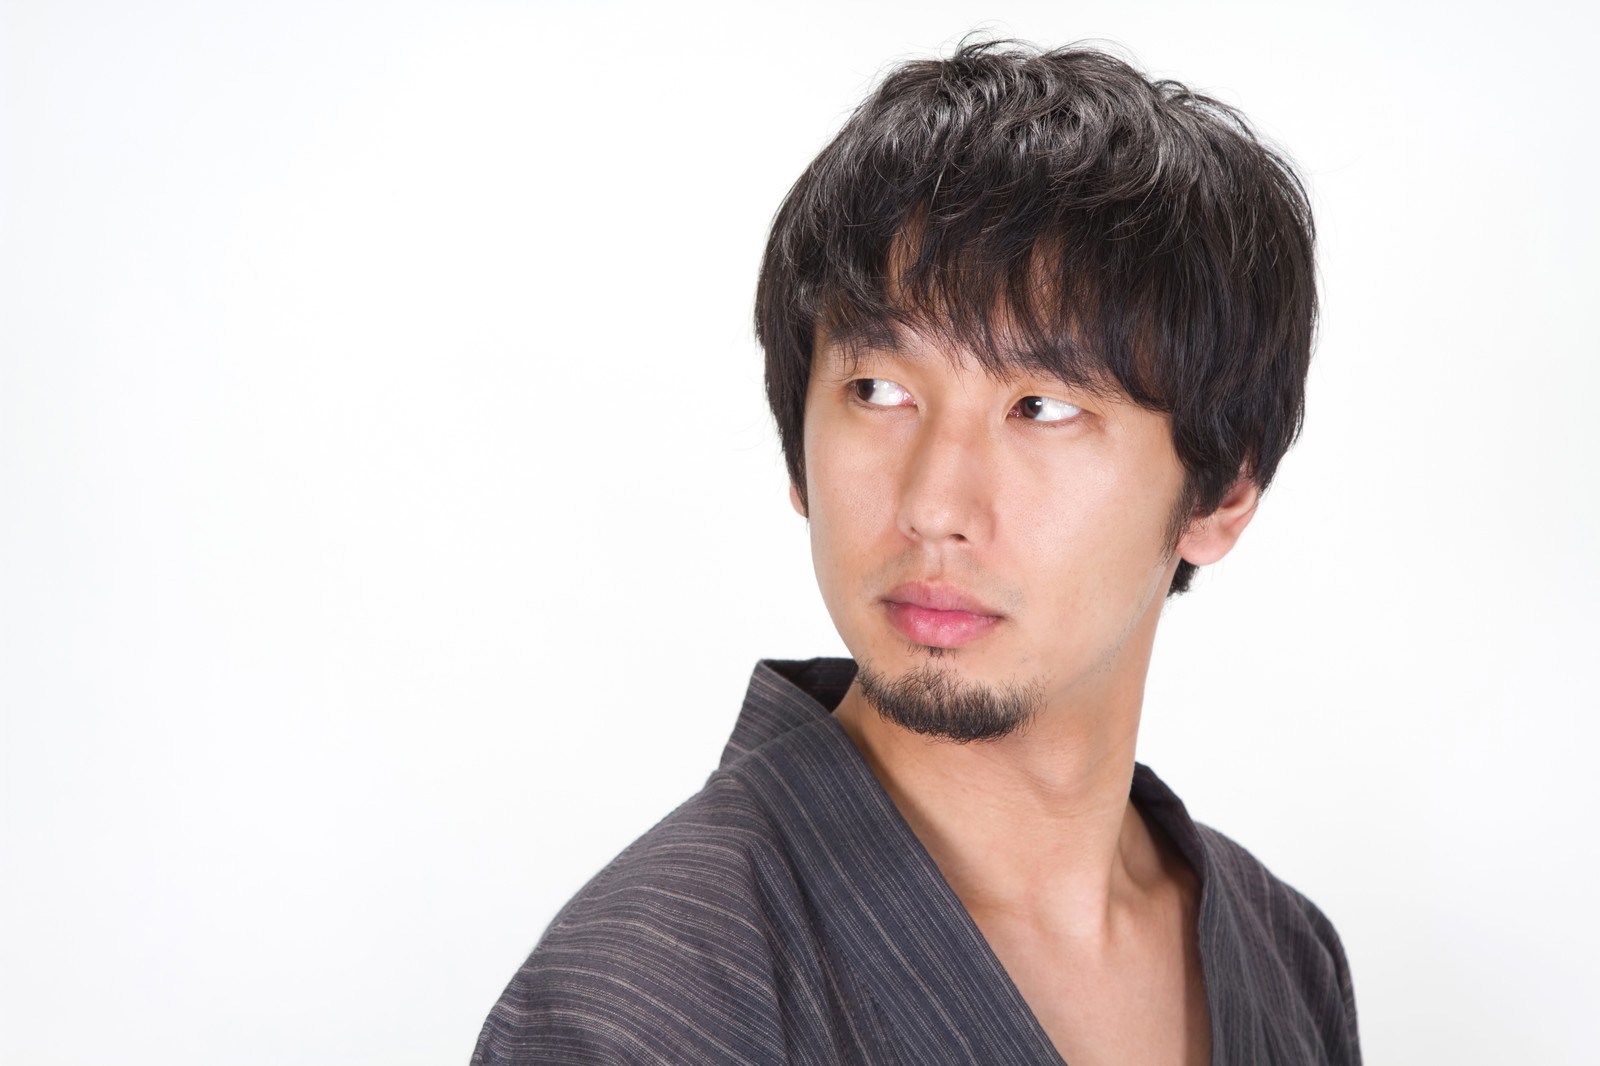
説明 { “tags”: [ “person”, “man”, “indoor”, “clothing”, “looking”, “front”, “shirt”, “holding”, “young”, “wearing”, “standing”, “laptop”, “black”, “glasses”, “sitting”, “hand”, “computer”, “suit”, “large”, “white”, “red” ], “captions”: [ { “text”: “a man wearing a black shirt”, “confidence”: 0.908824146 } ] }
タグ [ { “name”: “person”, “confidence”: 0.9991584 }, { “name”: “man”, “confidence”: 0.9983223 }, { “name”: “indoor”, “confidence”: 0.86834836 }, { “name”: “shirt”, “confidence”: 0.680425167 }, { “name”: “hairpiece”, “confidence”: 0.484340459 }, { “name”: “male”, “confidence”: 0.2009881 }, { “name”: “staring”, “confidence”: 0.164418563 } ]
「Confidence」は自信の意味もあります。個人的にはドヤ顔判断されたのだと思っています。
着物は襟のせいかスーツと判断されてますね、着物自体が学習されてないのかも?
■ネタ画像
最後はネタ画像で試してみます。
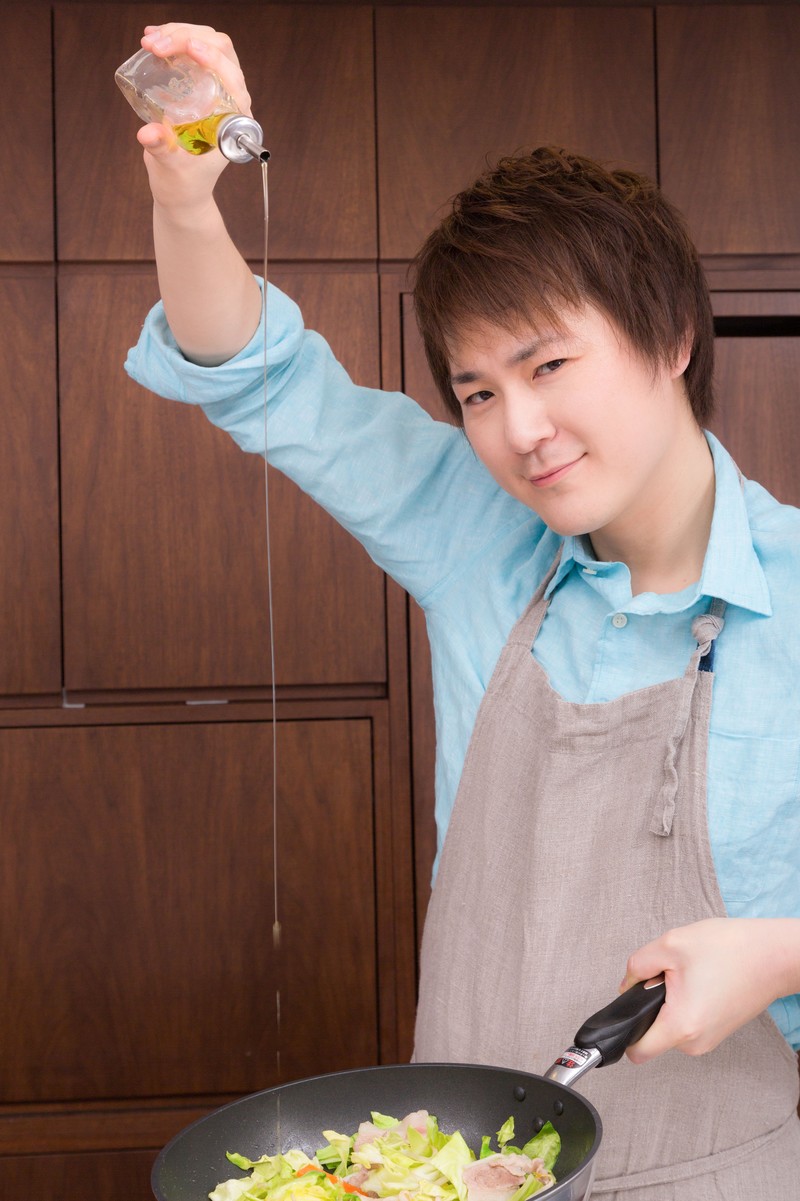
説明 { “tags”: [ “person”, “cabinet”, “food”, “indoor”, “table”, “kitchen”, “young”, “eating”, “holding”, “little”, “piece”, “plate”, “boy”, “child”, “front”, “sitting”, “small”, “standing”, “bowl”, “man”, “black”, “girl”, “shirt”, “cake”, “pizza”, “woman”, “wearing”, “blue”, “large”, “pan”, “phone” ], “captions”: [ { “text”: “a little boy that is eating some food”, “confidence”: 0.3904171 } ] }
まとめ
個人的にはComputer Vision APIの方が画像の指定も簡単かつ結果も詳細がでてくるといった印象です。
ただ人間の認証はどちらもまだまだ精度をあげられそうな印象ですね。
人間の判断でも難しいところがあるので、これからのAIの進化に期待したいですね。
次回もお楽しみに!!

